Uma solução de Inteligência Artificial é formada por diferentes camadas técnicas que trabalham em conjunto para transformar dados em valor.
Compreender essas camadas é essencial para que líderes, desenvolvedores e gestores saibam onde aplicar esforços, quais tecnologias priorizar e como reduzir riscos. Neste capítulo, você vai explorar os principais componentes de arquitetura, tecnologias e protocolos utilizados atualmente, com foco em aplicações práticas e decisões estratégicas.
Frontend vs. Backend
Qualquer aplicação de software, seja um site de e-commerce a uma ferramenta de IA, é composta por duas partes distintas, mas interdependentes: o frontend e o backend.
O Frontend (O “Palco”)
Esta é a parte da aplicação com a qual o usuário interage diretamente. É tudo o que se vê e se toca na tela: botões, menus, imagens, campos de formulário, layout e design visual. Também chamado de lado do cliente (client-side), o frontend é executado no navegador ou dispositivo do usuário.
O foco do frontend é oferecer uma interface intuitiva e uma experiência agradável, ou seja, garantir uma navegação fluida, rápida e responsiva em diferentes dispositivos (computadores, tablets, smartphones).
As tecnologias essenciais para o desenvolvimento frontend incluem:
HTML (HyperText Markup Language): estrutura o conteúdo da página.
CSS (Cascading Style Sheets): define o visual, o estilo e a disposição dos elementos.
JavaScript: adiciona interatividade, animações e comportamentos dinâmicos.
Backend (A “Cozinha”)
O backend é o que acontece por trás das cortinas. É o lado do servidor (server-side), o núcleo que executa toda a lógica da aplicação. Ele lida com o processamento de dados, autenticação de usuários, integrações com sistemas externos, e o armazenamento em bancos de dados.
Enquanto o frontend se preocupa com a aparência e a interação, o backend garante que tudo funcione corretamente, de forma segura, estável e escalável.
As tecnologias de backend variam conforme o projeto, mas algumas das mais comuns incluem:
Linguagens como Python, Java, Node.js e Ruby.
Bancos de dados como MySQL, PostgreSQL, MongoDB.
Serviços em nuvem, APIs e servidores web (como NGINX, Apache).
Frontend vs. Backend em Soluções de IA
O frontend em aplicações de IA é o ponto de contato direto com o usuário. Ele deve tornar a complexidade do backend compreensível e utilizável. Principais elementos:
Interfaces de chat – assistentes virtuais ou chatbots.
Dashboards com gráficos preditivos – análises claras e visuais.
Campos para envio de dados – textos, imagens, áudios ou outros formatos.
Feedback visual – mostra o que o modelo está fazendo ou recomendando.
Um bom frontend vai além de exibir resultados: ele traduz processos complexos em interações simples, reforçando a confiança, o entendimento e a usabilidade do sistema.
Backend em Ferramentas de IA
O backend é o cérebro por trás da aplicação de IA, onde toda a lógica e inteligência acontecem. Ele é responsável por:
Executar modelos de machine learning – carregamento, inferência e (em alguns casos) re-treinamento.
Processar e preparar dados – limpeza, normalização e análise dos dados recebidos.
Tomar decisões com IA – lógica de inferência baseada em entrada do usuário ou sistemas externos.
Conectar com infraestrutura – bancos de dados, APIs externas, serviços em nuvem e recursos de escalabilidade.
Diferente de backends tradicionais, o backend em IA não apenas executa regras fixas: ele aprende, adapta e raciocina conforme interage com os dados e com o ambiente.
Além disso, o backend pode ser conectado a APIs externas, permitindo que o assistente:
Consulte previsões do tempo
Acesse eventos da agenda
Utilize localização
Personalize respostas com base em dados do usuário
Esse exemplo mostra como o casamento entre frontend e backend é essencial para criar experiências realmente inteligentes e úteis para o usuário.
Por que frontend e backend importam nos negócios com IA?
Entender a separação entre frontend e backend é essencial para quem está planejando, investindo ou liderando projetos com Inteligência Artificial. Essa visão:
Ajuda a montar equipes certas (designers/UI para o frontend, cientistas de dados/devs para o backend).
Facilita decisões sobre onde investir mais (melhorar a experiência do usuário ou otimizar os modelos no backend?).
Permite visualizar a jornada completa: da interação do usuário até o processamento inteligente dos dados.
As próximas seções abordam os principais componentes de backend em soluções de IA — desde a engenharia de prompts até a infraestrutura de execução. Ao final deste capítulo, retomamos a discussão de frontend.
Prompt Engineering, RAG e Fine-tuning
Um modelo de IA genérico, como o GPT ou o Llama, é como um recém-formado brilhante: possui um conhecimento geral imenso, mas não sabe nada sobre as especificidades do seu negócio. Para transformá-lo em um especialista que entenda seus produtos, clientes e processos, é preciso “educá-lo”. Prompt Engineering, RAG e Fine-tuning são as três principais estratégias para essa educação, cada uma com diferentes níveis de custo, esforço e profundidade.
Prompt Engineering: Dando Instruções Claras
O que é: O Prompt Engineering é a prática de escrever instruções eficazes para guiar modelos de linguagem, como os LLMs, a gerar respostas úteis e consistentes. Trata-se da “arte” de fornecer instruções (prompts) detalhadas em tempo real para orientar a IA a produzir o resultado desejado. Embora não altere o conhecimento do modelo, molda a forma como ele utiliza suas informações naquele momento — afinal, toda interação com um LLM é, em sua essência, engenharia de prompt.
A Analogia: Pense nisso como ser um bom gerente. Você não ensina seu funcionário a falar português a cada nova tarefa; você apenas dá instruções claras sobre o que precisa ser feito, o formato esperado e o público-alvo. É uma habilidade comparável a fazer a pergunta certa em uma entrevista: quanto mais clara e bem estruturada for a questão, melhor será a resposta Liu et al. (2023).
Vantagens: Custo zero (além do tempo de desenvolvimento), resultados imediatos e acessibilidade total, sem necessidade de conhecimento técnico aprofundado.
Desvantagens: Não ensina o modelo permanentemente, não é escalável para tarefas complexas e se limita ao conhecimento pré-treinado do modelo.
Quando usar: Ideal para prototipagem, tarefas pontuais de escrita e como a base para todas as interações com LLMs. As técnicas de RAG e Fine-tuning, no fundo, são formas sofisticadas de automatizar e otimizar a engenharia de prompt.
Retrieval-Augmented Generation (RAG): Dando ao Modelo uma Base de Consulta
O que é: Retrieval-Augmented Generation (RAG) é uma técnica que combina LLMs com bases de conhecimento externas. Em vez de depender apenas do que o modelo aprendeu no treinamento, ele consulta documentos, bancos de dados ou APIs em tempo real Lewis et al. (2020). Quando um usuário faz uma pergunta, o sistema primeiro recupera as informações relevantes dessa base — que pode ser externa ou privada (como documentos internos ou catálogos de produtos) — e as injeta no prompt como contexto. A IA, então, utiliza esse material factual para formular respostas mais precisas e atualizadas.
Como Funciona: Para que a busca seja inteligente, seus documentos são processados e convertidos em representações numéricas (vetores) que capturam seu significado semântico. Estes vetores são armazenados em um Banco de Dados Vetorial (Vector DB). Esse banco de dados permite uma busca por significado, e não apenas por palavras-chave, encontrando o trecho mais relevante para a pergunta do usuário.
A Analogia: É como dar ao seu funcionário acesso a uma intranet corporativa moderna e com uma busca inteligente. Ele não precisa memorizar tudo; ele busca a informação relevante no momento exato em que precisa dela. A resposta é sempre baseada em uma fonte oficial.
Vantagens: Combate “alucinações” ao ancorar as respostas em fatos, permite que o conhecimento da IA esteja sempre atualizado (basta atualizar os documentos) e oferece transparência sobre a fonte da informação.
Desvantagens: A qualidade da resposta depende 100% da qualidade e organização da sua base de dados (“Garbage In, Garbage Out”). A implementação inicial é mais complexa, pois exige a configuração de um pipeline de dados (ingestão, fragmentação e vetorização dos documentos).
Quando usar: É a arquitetura padrão para a maioria dos assistentes virtuais de atendimento, assistentes de conhecimento interno e qualquer aplicação que precise responder perguntas com base em um corpo de informações específico e mutável.
Fine-tuning (Ajuste Fino): A “Pós-Graduação” da IA
O que é: Fine-tuning é o processo de continuar o treinamento de um modelo pré-existente usando um conjunto de dados proprietário e de alta qualidade (ex: centenas de exemplos de interações de suporte ao cliente). Você está, de fato, reescrevendo parte das conexões neurais do modelo para que ele aprenda um novo comportamento, estilo ou habilidade.
A Inovação do LoRA: Tradicionalmente, esse processo era extremamente caro. Hoje, técnicas como o LoRA (Low-Rank Adaptation) permitem ajustar o modelo de forma muito mais eficiente. Em vez de retreinar bilhões de parâmetros, o LoRA “congela” o modelo original e treina apenas uma pequena camada adicional de parâmetros. Isso reduz o custo computacional em mais de 90%, tornando o fine-tuning uma opção estratégica viável.
A Analogia: Fine-tuning não é dar um manual ao funcionário, é mandá-lo para uma pós-graduação. Ele não está mais apenas consultando informações; ele está internalizando um conhecimento tão profundo que sua própria maneira de “pensar” sobre um assunto é permanentemente alterada. LoRA seria o equivalente a um curso de especialização intensivo e focado, em vez de um doutorado de 5 anos.
Vantagens: Cria um ativo único e um diferencial competitivo real, é a melhor forma de ensinar à IA um tom de voz de marca específico e pode otimizar a performance e o custo para tarefas repetitivas.
Desvantagens: Ainda é a abordagem mais complexa, exige um bom conjunto de dados de treinamento e, se mal executado, carrega o risco de “esquecimento catastrófico” (o modelo se especializa tanto que perde habilidades gerais).
Quando usar: A distinção estratégica é clara: use RAG para ensinar à IA o que saber; use Fine-tuning para ensinar à IA como se comportar. É ideal para quando a própria habilidade da IA é o seu produto, como uma IA que aprende o estilo de um advogado para redigir rascunhos de documentos.
Para escolher a melhor abordagem ao implementar soluções com IA generativa, é fundamental considerar o custo, o esforço necessário e o nível de personalização desejado. A tabela a seguir compara três estratégias — Prompt Engineering, RAG e Fine-tuning — destacando seus principais atributos e o tipo de problema que cada uma resolve:
| Estratégia | Custo/Esforço | Nível de Personalização | Resolve o problema de ... |
|---|---|---|---|
| Prompt Engineering | Baixo | Baixo (Guia a IA) | ...dar a instrução correta |
| RAG | Médio | Médio (Dá conhecimento) | ...não saber a informação correta. |
| Fine-tuning (com LoRA) | Alto | Alto (Muda o comportamento) | ...não ter a habilidade correta. |
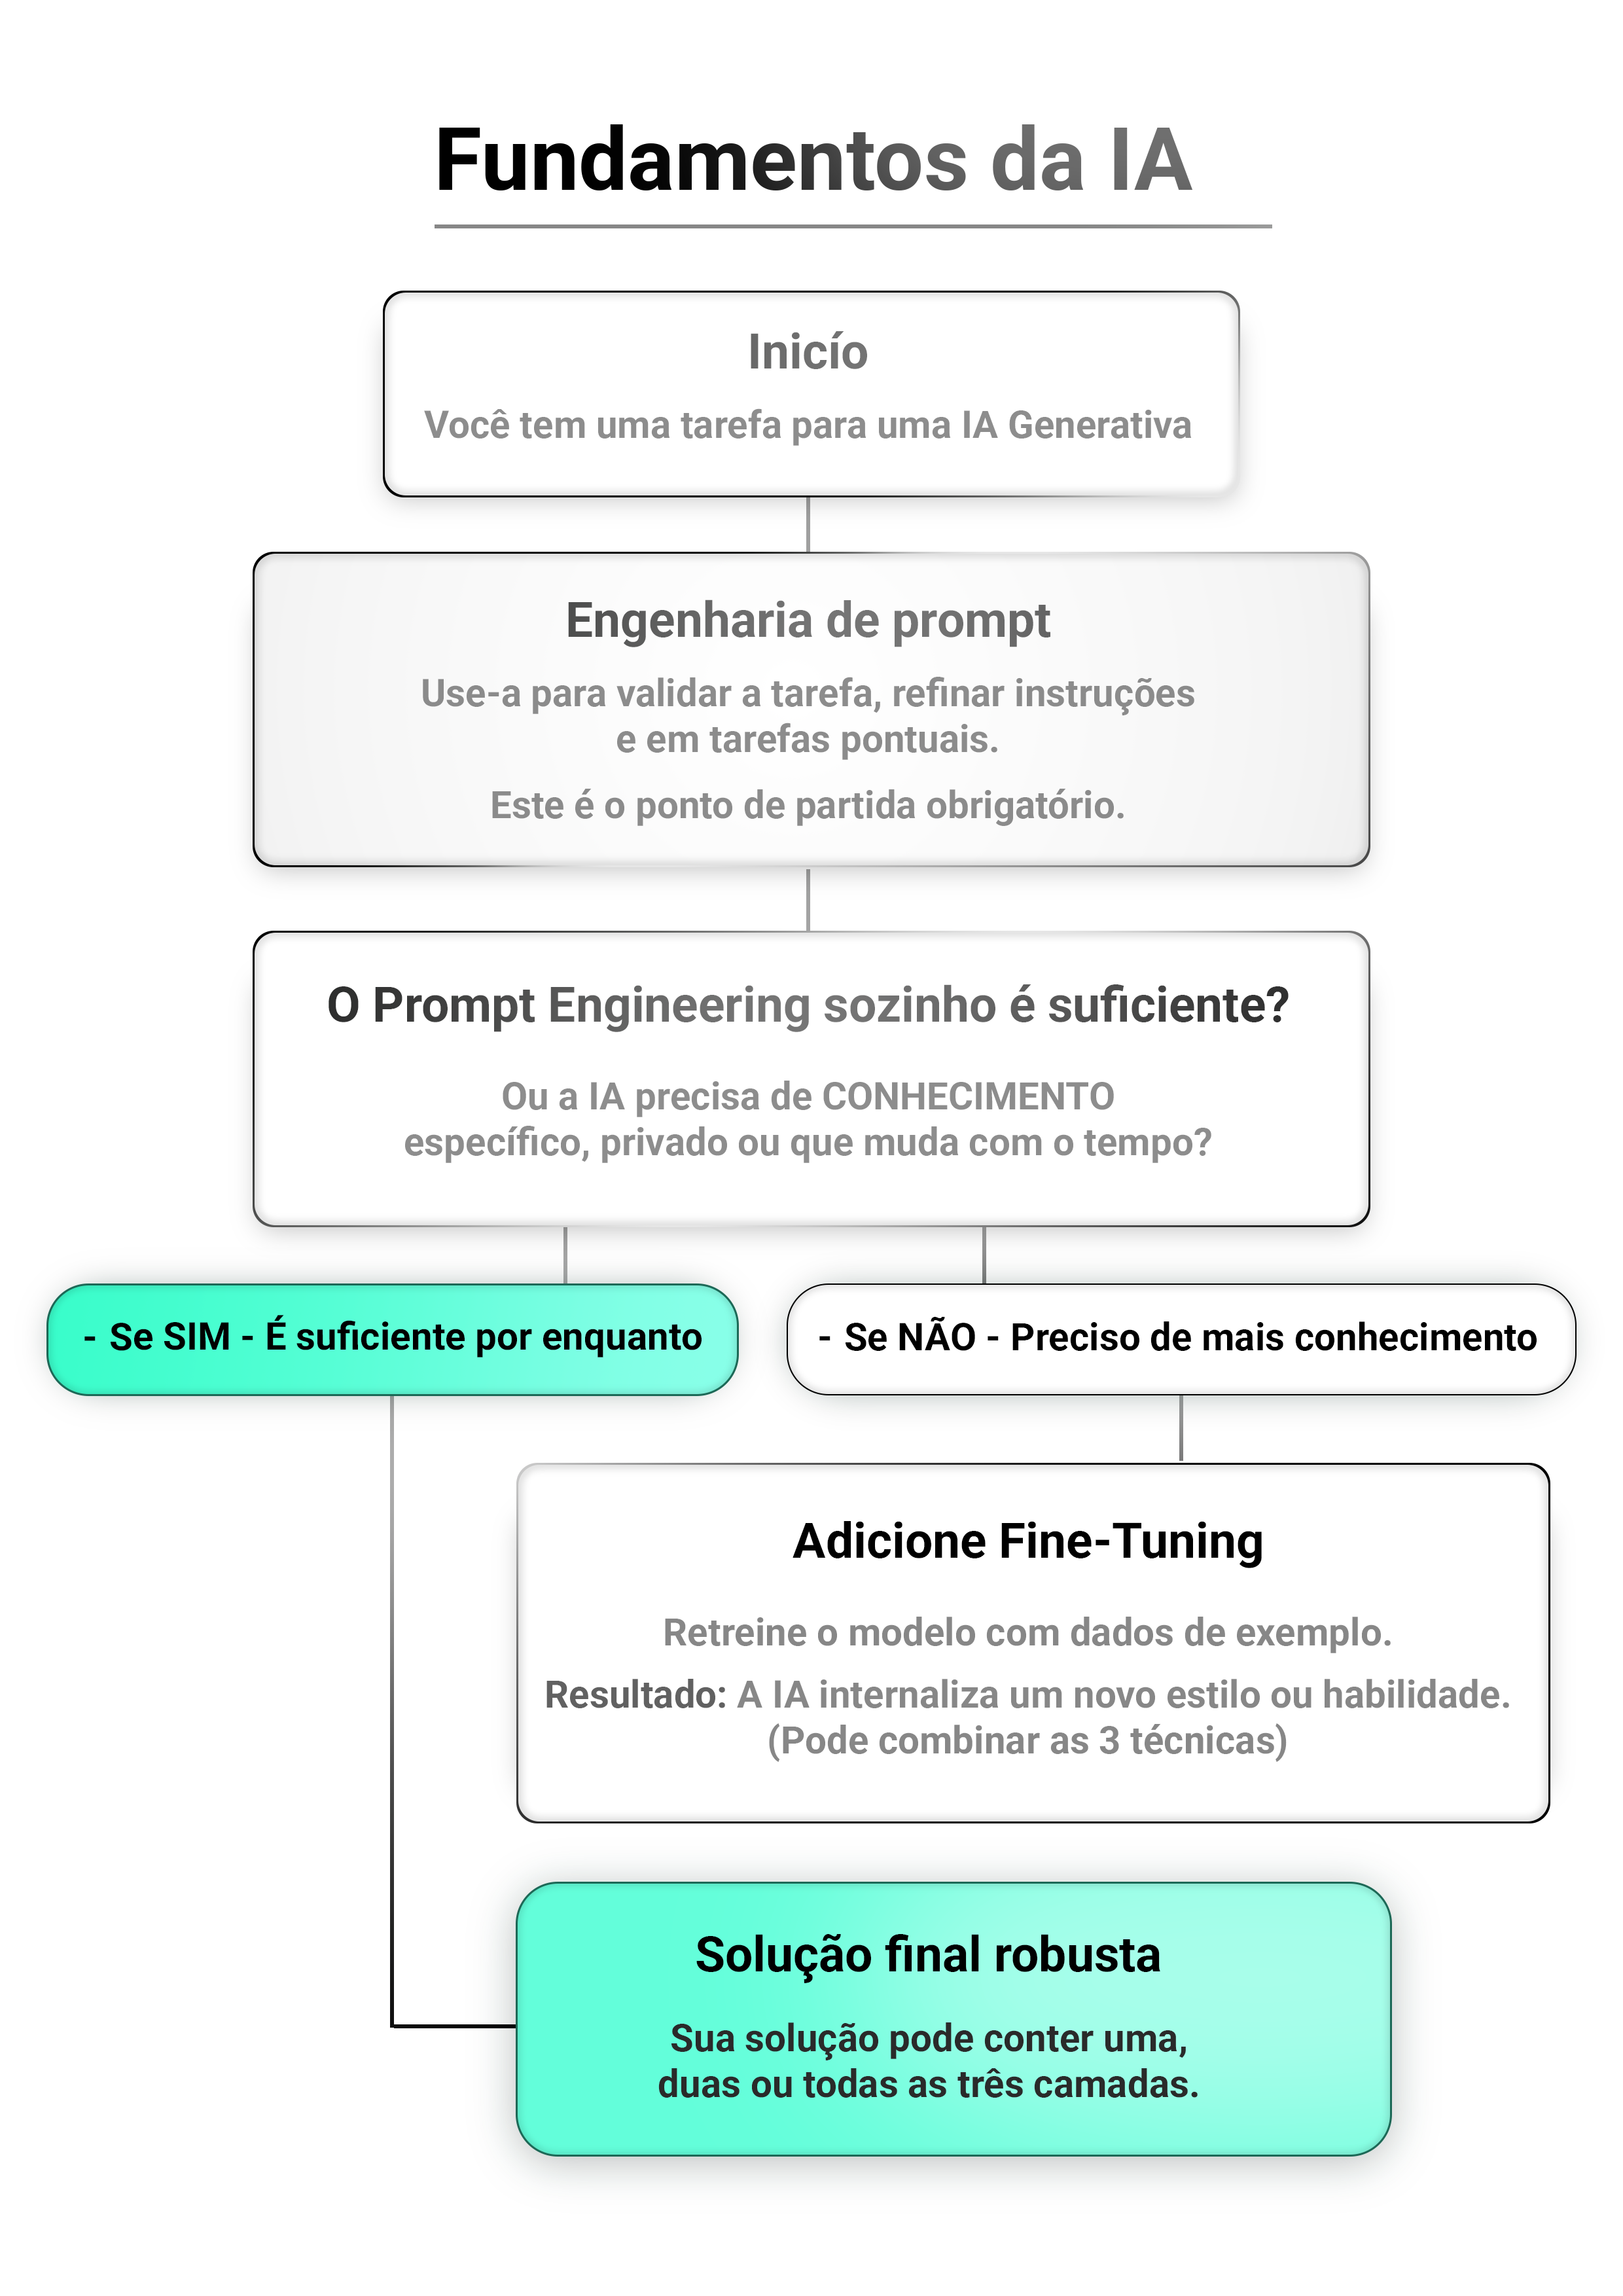
Agora, visualize esse caminho passo a passo no fluxograma abaixo, que ilustra a jornada recomendada para o desenvolvimento de soluções com Inteligência Artificial.
API e Integração
Até agora, vimos como usar a IA para gerar ideias, conteúdo, protótipos e até automatizar partes do processo de criação. Mas existe um ponto em que muitos criadores se perguntam:
Como eu faço essa IA funcionar dentro do meu produto ou negócio?
A resposta quase sempre envolve uma sigla: API.
API significa Application Programming Interface ou, em português, Interface de Programação de Aplicações. É o “idioma” que permite que sistemas diferentes se comuniquem Fielding (2000).
No contexto de IA, as APIs conectam modelos a aplicativos, websites ou sistemas corporativos.
As APIs tornam a IA modular e escalável, permitindo que empresas adicionem inteligência a sistemas já existentes sem reconstruí-los do zero. É como se você pudesse “conversar com a IA por código” e integrá-la diretamente ao seu site, app, sistema ou processo de negócio.
Automatizando ainda mais com Webhooks
Se a API é a ponte que permite que você faça pedidos para a IA, os webhooks são como sinais automáticos que avisam quando algo acontece — e isso pode acionar a IA sem que você precise fazer nada manualmente.
Imagine esses cenários:
Um cliente faz um pedido → o webhook dispara → a IA envia uma mensagem personalizada de agradecimento.
Um pagamento é confirmado → o webhook dispara → a IA inicia um processo automatizado de onboarding.
Um formulário é enviado → o webhook dispara → a IA analisa os dados e gera uma resposta em segundos.
Ao combinar APIs e webhooks, você cria sistemas onde a IA não só responde quando solicitada, mas também entra em ação automaticamente assim que um evento ocorre. Isso torna a automação muito mais fluida, eficiente e inteligente — exatamente o tipo de experiência que diferencia um negócio moderno no mercado.
Integração de API e Agentes de IA
Com a evolução dos agentes de inteligência artificial, o uso de APIs está ganhando uma nova dimensão
mais dinâmica, inteligente e autônoma.
Enquanto modelos tradicionais apenas respondem a comandos, agentes interpretam, planejam e agem:
Buscam informações em tempo real
Tomam decisões com base em múltiplas variáveis
Acionam APIs para manipular sistemas e executar tarefas
Hoje, APIs não são apenas conectores. Elas se tornaram ferramentas de ação no ecossistema dos agentes, permitindo automações como:
Consultar bancos de dados
Fazer scraping de páginas
Integrar múltiplos serviços em fluxos inteligentes
Isso inaugura um novo paradigma: agentes que usam linguagem natural para interagir com a infraestrutura digital — e fazem isso sem depender de desenvolvedores a cada passo.
O código a seguir, desenvolvido em Python, demonstra como integrar um modelo de IA generativa (OpenAI GPT-4) a um sistema de atendimento automatizado via WhatsApp, utilizando a API do Z-API. O fluxo é simples:
Entrada: o paciente envia uma mensagem ou dúvida via formulário ou WhatsApp.
Processamento: o modelo de IA interpreta a pergunta, gera uma resposta clara e humanizada, e a função enviar_resposta_whatsapp envia essa resposta de volta pelo canal.
Saída: o paciente recebe a resposta automaticamente, sem intervenção manual.
Com esse exemplo, o leitor entende como configurar um webhook para receber mensagens, processá-las com IA e devolvê-las de forma automática, criando assim um atendimento inteligente e escalável.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44from flask import Flask, request, jsonify import requests import openai # Configurações openai.api_key = "SUA_CHAVE_OPENAI" ZAPI_TOKEN = "seu_token_zapi" ZAPI_URL = "https://api.z-api.io/instances/SUA_INSTANCIA/token/SUA_TOKEN/send-messages" app = Flask(__name__) def gerar_resposta(pergunta): response = openai.ChatCompletion.create( model="gpt-4", messages=[ {"role": "system", "content": "Você é um atendente simpático e informativo de uma clínica médica."}, {"role": "user", "content": pergunta} ] ) return response.choices[0].message.content.strip() def enviar_resposta_whatsapp(numero, mensagem): payload = { "phone": numero, "message": mensagem } headers = {"Content-Type": "application/json"} r = requests.post(ZAPI_URL, json=payload, headers=headers) return r.status_code == 200 @app.route("/webhook", methods=["POST"]) def receber_mensagem(): data = request.get_json() numero = data.get("phone") # WhatsApp number mensagem = data.get("message") # Mensagem enviada pelo paciente if numero and mensagem: resposta = gerar_resposta(mensagem) sucesso = enviar_resposta_whatsapp(numero, resposta) return jsonify({"status": "ok", "resposta": resposta, "enviado": sucesso}) return jsonify({"status": "erro", "mensagem": "Dados incompletos"}), 400 if __name__ == "__main__": app.run(port=5000)
Exemplo prático, em Python, de webhook com Flask conectado ao WhatsApp usando Twilio
API na criação de negócios: o poder da automação
Integrar APIs de Inteligência Artificial ao seu negócio é uma das formas mais rápidas de automatizar processos e aumentar a produtividade, sem precisar construir modelos do zero.
A tabela abaixo mostra exemplos práticos de tarefas que você pode automatizar e quais APIs utilizar para cada uma. Essa é a ponte entre o que sua empresa precisa e o que a IA pode entregar.
| Tarefa | API que pode ser usada |
|---|---|
| Geração de textos | OpenAI (GPT), Anthropic (Claude), Mistral |
| Geração de imagens | DALL·E, Midjourney (via wrappers), Stability |
| Classificação de dados | OpenAI embeddings, Google Cloud Vision, Hugging Face |
| Tradução, resumo, análise de sentimentos | GPT, DeepL, Cohere |
| Voz e áudio | ElevenLabs, Whisper, Google TTS/STT |
| Criação de automações | Zapier, Make.com, n8n (integram APIs sem código) |
Não sei programar. Posso usar API mesmo assim?
Sim. Mesmo sem saber programar, você pode integrar APIs usando ferramentas no-code e low-code — plataformas que permitem montar fluxos automáticos com lógica visual, arrastando blocos, definindo ações e conectando serviços, tudo sem escrever uma linha de código.
Essas ferramentas são ideais para profissionais de qualquer área que desejam automatizar tarefas, criar produtos ou integrar sistemas de forma rápida e acessível.
Tudo isso feito com conectores visuais e regras simples, sem programar.
Vibe Coding — Criando com IA no Ritmo da Ideia
O Vibe Coding é um estilo emergente de desenvolvimento que transforma a forma como criamos soluções digitais. Em vez de seguir um processo tradicional, com longas etapas de planejamento, configuração de ambiente e escrita manual de código, o vibe coder simplesmente descreve o que deseja — e a IA traduz essa ideia em código funcional em segundos. Digamos que, nesse modelo, a programação tradicional é complementada por colaboração interativa com LLMs, que sugerem código, explicações e até protótipos funcionais Wu et al. (2022).
Essa abordagem torna o processo mais leve, acessível e criativo, ideal para quem quer testar ideias rapidamente e prototipar sem barreiras técnicas.
Exemplo prático de uso da metodologia Vibe Coding
Veja a seguir o passo a passo de como ocorre a interação entre o usuário e a IA via Vibe Coding
Interação entre Designer e IA via Vibe Coding
1. Conversa Inicial com a IA
O designer abre uma ferramenta como o ChatGPT com Code Interpreter ou um ambiente como Replit + Copilot e digita:
Quero um app simples onde o usuário escreve uma frase e, com base nisso, uma imagem é gerada usando IA. Pode ser feito com Streamlit.
2. Primeira Resposta da IA
A IA gera o esqueleto de código:
import streamlit as st
import openai

st.title("Gerador de Imagens para Marketing")
frase = st.text_input("Descreva a imagem que deseja")

if st.button("Gerar"):
    # chamada para API de imagem
    imagem = gerar_imagem(frase)  # função hipotética
    st.image(imagem)
Este exemplo é meramente ilustrativo, para um exemplo real para uma aplicação do tipo. Para uma versão mais completa de uma aplicação do tipo, veja o exemplo no GitHub de recursos do livro. Para uma visão mais completa do processo, confira esse vídeo.
3. Iterações com a IA
O designer digita:
Coloque um botão mais estilizado, com ícone de câmera, e uma cor chamativa.
A IA atualiza o layout com novos elementos visuais e interações.
4. Testes de Funcionalidade
O designer solicita:
Adicione uma função para salvar a imagem localmente com o nome do usuário.
5. Protótipo Pronto para Demonstração
Em poucos minutos, o app está funcional e pode ser testado com colegas ou potenciais usuários para feedback.
Como o Empreendedor Pode Usar Vibe Coding
Para quem lidera um negócio ou startup, o Vibe Coding é uma ferramenta poderosa de inovação e experimentação:
Criar MVPs (produtos mínimos viáveis) em tempo recorde para testar propostas de valor.
Validar novos recursos de IA antes de investir em desenvolvimento completo.
Construir automações internas e dashboards inteligentes com custo quase zero.
Capacitar times não técnicos a prototipar soluções próprias, reduzindo gargalos de TI.
O Vibe Coding é um divisor de águas:
Democratiza o desenvolvimento.
Reduz o medo de começar.
Incentiva a criatividade.
Mas cada atalho cobra seu preço: cabe ao empreendedor equilibrar velocidade e sustentabilidade técnica, decidindo quando a agilidade compensa e quando é preciso mais profundidade.
Como funciona uma chamada de API de modelo de linguagem?
Uma chamada de API para um modelo de linguagem (como o GPT da OpenAI) funciona como um diálogo estruturado entre o usuário e o modelo, mediado por uma requisição HTTP contendo um prompt — ou seja, um conjunto de mensagens que simulam uma conversa.
Esse prompt é composto por uma lista de mensagens, cada uma com três componentes principais:
role— função de quem falacontent— conteúdo textual da falaname(opcional) — para identificar participantes
A comunicação geralmente segue esta ordem:
Começa com uma mensagem de
role: system, que define o comportamento ou a personalidade do modelo
Exemplo: “Você é um assistente médico educado e direto”.Em seguida:
Mensagens de
role: user— entrada do usuárioMensagens de
role: assistant— respostas anteriores (caso existam)
Essa estrutura permite que o modelo:
Compreenda o que se espera dele
Tenha acesso ao histórico da conversa (caso fornecido)
A resposta é então gerada com base nesse contexto textual, e pode ser ajustada por parâmetros como:
temperature— controla a criatividademax_tokens— define o comprimento máximo da resposta
Explicação por partes — campos importantes da chamada
Como é feita uma chamada para o modelo da OpenAI?
Para interagir com um modelo como o GPT-4, você precisa enviar uma requisição HTTP contendo informações específicas. A estrutura dessa requisição é feita em formato JSON, e deve conter os parâmetros adequados para simular um diálogo com o modelo. Veja um exemplo:
1 2 3 4 5 6 7 8 9 10{ "model": "gpt-4", "messages": [ {"role": "system", "content": "Você é um atendente virtual simpático de uma clínica médica."}, {"role": "user", "content": "Quanto custa uma consulta?"}, {"role": "assistant", "content": "Uma consulta de rotina custa R$ 150,00. Posso agendar para você?"} ], "temperature": 0.5, "max_tokens": 300 }
Entendendo os Campos da Requisição
Para dominar o uso dessa API, é essencial compreender o que cada campo significa.
A tabela abaixo resume os principais elementos:
| Campo | O que é |
|---|---|
model | Define qual modelo será usado (ex: gpt-4, gpt-3.5-turbo) |
messages | Lista ordenada de mensagens simulando um diálogo |
role | Pode ser ‘system’, ‘user’ ou ‘assistant’ |
content | Conteúdo textual da mensagem (o prompt real) |
temperature | Controla a criatividade da resposta (0 = exata, 1 = criativa) |
max_tokens | Número máximo de tokens gerados (limita o tamanho da resposta) |
Embora sejam eficazes em muitos cenários, as chamadas diretas à API podem se tornar limitadas quando o objetivo é criar fluxos mais complexos, com múltiplas etapas, tomada de decisões dinâmicas ou integrações com diferentes sistemas.
Token counting, custo e desempenho
Entendendo o que é token counting: Ao usar modelos de linguagem via API (como o GPT-4), cada chamada é tarifada com base na quantidade de tokens processados – ou seja:
Tanto a entrada (
prompt)Quanto a saída (
completion)
O que é um token? Um token é uma pequena unidade de texto, geralmente entre 3 e 4 caracteres.
Por que Token counting importa?
Tokens impactam diretamente no custo, velocidade e qualidade das respostas, pois:
Textos longos → mais tokens → custos mais altos
Conversas extensas → podem ultrapassar o limite do modelo
Prompts grandes → demoram mais para serem processados
Benefícios de entender a contagem de tokens:
Evita cobranças excessivas
Melhora a performance da aplicação
Garante equilíbrio entre custo, velocidade e qualidade da resposta
Tabela de referência — Tokens, preços e limites (valores de referência em dezembro/2025 — consulte sempre a documentação oficial para preços atualizados)
| Modelo | Limite de tokens (entrada + saída) | Preço (1K tokens) prompt | Preço (1K tokens) resposta | Notas |
|---|---|---|---|---|
gpt-3.5-turbo | 16.384 tokens | $0.0005 | $0.0015 | Rápido, barato, ideal para MVP |
gpt-4-turbo | 128.000 tokens | $0.01 | $0.03 | Poderoso, ótimo para agentes |
gpt-4 (legacy) | 8.192 tokens | $0.03 | $0.06 | Mais caro, menos usado hoje |
Claude 3 Haiku | 200.000+ tokens | Variável (baixo) | Variável | Ideal para PDFs/documentos longos |
Mistral 7B | 32.000 tokens | Gratuito (self-hosted) | Gratuito | Open source, precisa infra própria |
Boas práticas para otimizar o uso de tokens
Aplicar boas práticas na construção dos prompts e na configuração dos parâmetros da API pode reduzir custos e melhorar o desempenho. A seguir, veja algumas recomendações úteis para otimizar o uso de tokens:
| Prática | Explicação |
|---|---|
| Resuma históricos longos | Em vez de passar 10 mensagens antigas, envie um resumo em 1-2 frases |
| Use prompts objetivos | Evite descrições desnecessárias (“Você é uma IA muito inteligente que...”) |
Limite o max_tokens | Não peça mais resposta do que realmente precisa (ex: 200–500 tokens) |
| Evite duplicações | Muitos prompts repetem instruções ou contexto de forma redundante |
| Conte os tokens antes | Use tiktoken (OpenAI) ou anthropic_tokenizer para calcular previamente |
| Use modelos mais baratos | Para tarefas simples, gpt-3.5 pode ser suficiente |
Por que o uso de IA importa na criação de negócios?
Para que a adoção de Inteligência Artificial realmente gere impacto nos negócios, é fundamental entender por que ela importa na prática. Não se trata apenas de uma tecnologia “da moda”, mas de um verdadeiro diferencial competitivo que pode transformar o modo como sua empresa opera. A IA permite escalar processos sem aumentar custos com equipe, automatizar rotinas de forma inteligente, entregar soluções sob medida em grande escala e se conectar com as ferramentas que sua empresa já usa no dia a dia.
APIs são como “braços da IA” que você pode embutir no seu negócio para entregar valor automaticamente.
Antes de integrar APIs de inteligência artificial ao seu sistema ou projeto, é essencial estar atento a alguns pontos críticos que podem impactar diretamente a viabilidade, segurança e desempenho da sua aplicação:
Usar IA na criação de negócios vai além de ferramentas prontas: ao integrar APIs de IA aos seus próprios sistemas, é possível transformar ideias em soluções automatizadas, escaláveis e inteligentes.
Rodar Localmente vs. Cloud Computing
As soluções de IA podem ser executadas de duas formas principais:
Localmente (on-premise): oferece maior controle sobre os dados e reduz riscos de exposição, mas exige servidores robustos, equipe técnica especializada e custos elevados de manutenção.
Na nuvem (cloud computing): oferece escalabilidade, menor custo inicial e acesso rápido a modelos pré-treinados Armbrust et al. (2010).
Após definir qual modelo de IA usar, a próxima pergunta estratégica é onde ele vai operar. Esta não é uma decisão de TI, mas uma decisão de negócio que impacta custos, segurança, agilidade e controle. A escolha se resume a um dilema clássico, análogo a uma decisão de logística: você deve usar um serviço de transporte flexível como o Uber (nuvem) ou comprar sua própria frota de veículos (localmente)?
Cloud Computing: Alugando a Superpotência
O que é: Em vez de investir em uma infraestrutura própria, você pode alugar o poder computacional de empresas especializadas. Isso inclui gigantes como Amazon (AWS), Google (GCP) e Microsoft (Azure), os chamados hiperescaladores, além de provedores focados em IA de alta performance, como CoreWeave e Lambda.
Enquanto os hiperescaladores oferecem escala global, as nuvens especializadas competem com hardware otimizado, entregando mais performance por dólar em tarefas específicas de IA. Em todos os casos, você paga apenas pelo uso, convertendo grandes investimentos em infraestrutura (CapEx) em custos operacionais mensais previsíveis (OpEx).
Categoria | Descrição |
|---|---|
VANTAGENS | Agilidade e Baixo Custo Inicial: A barreira de entrada é praticamente zero. É possível começar a experimentar e escalar uma aplicação de IA em questão de horas, sem comprar um único servidor. |
Escalabilidade Elástica: Se sua demanda explodir, a capacidade da nuvem se ajusta automaticamente. Você paga apenas pelo que usa, evitando o desperdício de capacidade ociosa. | |
Acesso à Inovação: Você tem acesso imediato às GPUs e processadores mais recentes do mercado sem precisar renovar máquinas próprias. | |
DESVANTAGENS | Custo em Escala: Para uma operação grande e constante, o aluguel pode se tornar mais caro do que a posse a longo prazo. O custo operacional pode ser volátil e difícil de prever. |
Soberania e Privacidade de Dados: Seus dados residem na infraestrutura de outra empresa, o que é um ponto crítico para setores regulados como saúde, finanças e governo. | |
Dependência do Fornecedor (Lock-in): Construir sua operação sobre os serviços específicos de um provedor torna a migração para um concorrente cara e complexa. |
Quando usar?
É a escolha padrão para a maioria das startups e empresas, especialmente para prototipagem, aplicações com demanda variável ou negócios que querem focar no produto, não na gestão de infraestrutura.
Computação Local: Assumindo o Controle Total
O que é: Operar os modelos de IA em hardware que você possui e controla. Isso se manifesta de duas formas principais:
On-Premise: Servidores e GPUs instalados em seu próprio data center. É a “frota de caminhões” da nossa analogia.
Edge AI: Uma forma específica de computação local onde modelos otimizados rodam diretamente em dispositivos — como um smartphone, um terminal de ponto de venda, um sensor em uma fábrica ou uma câmera inteligente. É o “veículo de entrega final”, operando de forma autônoma na ponta.
Categoria | Descrição |
|---|---|
VANTAGENS | Controle e Segurança Máximos: Os dados nunca deixam sua rede (on-premise) ou seu dispositivo (edge), garantindo máxima privacidade e conformidade com leis como a LGPD/GDPR. |
Baixíssima Latência e Operação Offline: No Edge AI, a resposta é instantânea, pois não há viagem de ida e volta para a nuvem. A aplicação funciona mesmo sem conexão com a internet. | |
Redução de Custos de Dados: Processar dados localmente (como um feed de vídeo) evita os altos custos de transmissão e armazenamento na nuvem. | |
Custo-Benefício em Escala Previsível: Para cargas de trabalho massivas e constantes, o Custo Total de Propriedade (TCO) de uma infraestrutura on-premise pode ser menor do que o aluguel na nuvem a longo prazo. | |
DESVANTAGENS | Alto Custo Inicial e Complexidade: Exige um grande investimento em hardware e uma equipe especializada (MLOps) para gerenciá-lo. |
Escalabilidade Rígida: Aumentar a capacidade significa comprar mais hardware, um processo lento e caro. |
Quando usar?
On-premise é por vezes obrigatório para setores regulados. Edge AI é essencial para aplicações que exigem tempo de resposta em tempo real e/ou operação offline, como reconhecimento facial em celulares ou controle de qualidade em uma linha de montagem.
Um Modelo Híbrido Pode Ser a Resposta?
Para boa parte das empresas, a escolha não é “um ou outro”, mas sim “ambos, para finalidades diferentes”. A abordagem híbrida combina o melhor dos dois mundos.
Outras alternativas para construção do Frontend
Ao iniciar a jornada para desenvolver interfaces digitais muitos empreendedores e profissionais não técnicos podem se deparar com um desafio: por onde começar? Quais habilidades são realmente necessárias? Que tecnologias usar?
Para responder a essas perguntas, surgiram plataformas educativas que organizam o processo de aprendizado por meio de roteiros visuais de carreira (conhecidos como roadmaps). Esses roadmaps mostram, de forma estruturada, quais são as ferramentas, linguagens e conhecimentos mais relevantes para cada etapa do desenvolvimento, desde o nível iniciante até o avançado.
Plataformas de Progressão em Desenvolvimento Web
roadmap.sh
Um site gratuito que oferece mapas de carreira para diferentes áreas da tecnologia, incluindo frontend. Mostra de forma visual e hierárquica quais tópicos são essenciais, recomendados ou opcionais.FreeCodeCamp
Uma das plataformas gratuitas mais conhecidas no mundo da programação. Possui cursos práticos e estruturados sobre HTML, CSS, JavaScript e frameworks populares, voltados para construção de sites e aplicações web.Codecademy
Oferece trilhas de aprendizado guiadas e interativas. Ideal para quem quer aprender na prática e ter uma progressão passo a passo com feedback imediato.Pluralsight Paths
Plataforma voltada à capacitação profissional em tecnologia. Possui trilhas para desenvolvimento frontend, UX/UI e ferramentas de design, sendo útil também para líderes técnicos e empreendedores com foco estratégico.
Essas alternativas podem ser pontos de partida para quem deseja se capacitar ou simplesmente entender melhor como funcionam as tecnologias por trás das interfaces digitais modernas.
Ferramentas para ajudar a criar seu design
Criar o design de uma aplicação envolve uma série de decisões visuais e funcionais. Algumas dessas etapas — como a escolha da paleta de cores, referências visuais e seleção de ícones — podem ser significativamente facilitadas com o uso de ferramentas prontas e acessíveis. No entanto, aspectos mais profundos como a definição da identidade visual, a experiência do usuário (UX) e a integração entre design e funcionalidade devem ser desenvolvidos com atenção pelo próprio criador, considerando os objetivos da aplicação e as necessidades dos usuários.
IA’s para criação de Frontend
A chegada das IAs para criação de interfaces (Frontend) está redefinindo o processo de desenvolvimento de produtos digitais. Antes, o design e o código da interface precisavam ser criados manualmente — linha por linha. Hoje, essas ferramentas permitem gerar componentes completos, páginas inteiras e até aplicações funcionais, a partir de uma simples descrição em linguagem natural.
Essas soluções aceleram o fluxo de trabalho e reduzem a barreira entre ideia e protótipo, permitindo que designers, desenvolvedores e até empreendedores sem experiência técnica possam visualizar e testar conceitos rapidamente. Além da produtividade, elas ajudam a padronizar estilos, sugerem boas práticas de design responsivo e facilitam a integração com frameworks modernos.
Para o desenvolvedor, o uso dessas ferramentas não elimina a necessidade de conhecimento técnico.
Exemplos de landing page
Landing pages são páginas únicas projetadas para um objetivo específico — geralmente converter visitantes em leads ou clientes. Ao tratar de front end, não basta criar apenas o visual, é essencial projetar elementos como headline, proposta de valor clara, provas sociais e call‑to‑action fortes. As landing pages mais bem‑sucedidas são aquelas que combinam mensagem direta, design focado e experiência fluida.
Esses exemplos ajudam a visualizar como estruturar sua própria landing page e que aspectos priorizar para que ela realmente converta.
Figma
O Figma é uma plataforma de design colaborativo baseada na web que revolucionou a forma como interfaces digitais são projetadas. Ao longo desta seção, discutimos ferramentas para criar o front end de aplicações, desde referências visuais até geração de código com IA. O Figma se conecta diretamente a esse universo como a principal solução para prototipagem de interfaces, criação de wireframes, definição de fluxos de navegação e colaboração entre equipes de design e desenvolvimento. Ele permite que designers e desenvolvedores trabalhem simultaneamente em tempo real, com total visibilidade das alterações, comentários e decisões tomadas durante o processo criativo.
Além disso, o Figma pode ser expandido com plugins poderosos que automatizam tarefas e aproximam ainda mais o design da implementação técnica. Veja abaixo algumas ferramentas essenciais:
Figma: plataforma principal de design colaborativo, permite criar protótipos interativos, testar fluxos de usuário, e preparar arquivos prontos para desenvolvimento.
Codia: plugin que transforma seus designs Figma em código HTML/CSS limpo, economizando tempo na transição do design para o desenvolvimento.
Teleport: permite exportar componentes do Figma diretamente como projetos front-end, prontos para edição e customização em plataformas como React, Vue ou Angular.
Anima: transforma seus designs em páginas responsivas com código HTML, React e CSS, e ainda permite testar os protótipos com comportamento realista diretamente no navegador.
Essas ferramentas permitem que empreendedores e desenvolvedores otimizem o tempo de desenvolvimento, garantam consistência visual e reduzam a distância entre o design e o código final. O Figma não é apenas uma ferramenta de design; é um hub estratégico para transformar ideias em produtos digitais com mais rapidez e precisão.
UX de IA — Interação Humano-Sistema
A Experiência do Usuário (User Experience - UX) no contexto da IA refere-se ao design de toda a jornada de interação entre um ser humano e um sistema inteligente. Isso vai muito além do design de uma interface visual. Envolve moldar como o sistema se comporta, como comunica suas capacidades e limitações, e como colabora com o usuário para atingir um objetivo.
Projetar para IA apresenta desafios únicos que diferem fundamentalmente do design de software tradicional. O software convencional é determinístico: clicar em um botão sempre produz o mesmo resultado. Os sistemas de IA, especialmente os generativos, são probabilísticos: o mesmo prompt pode gerar resultados diferentes, e o sistema pode cometer erros de maneiras imprevisíveis, muitas vezes com um alto grau de confiança aparente.
Essa incerteza inerente significa que o usuário não consegue construir um modelo mental perfeito do funcionamento do sistema. Portanto, o papel do designer de UX para IA muda de projetar um fluxo previsível e perfeito para projetar uma relação resiliente entre o usuário e a máquina. Essa relação deve ser construída sobre uma base de confiança, e os principais objetivos do design de UX para IA são tornar as capacidades do sistema compreensíveis, suas saídas úteis e a experiência geral segura e valiosa.
UX de IA — Interação Humano-Sistema na Criação de Negócios
Usar a Inteligência Artificial para criar negócios é cada vez mais acessível mas a experiência de uso continua sendo o diferencial que separa uma boa ideia de uma proposta viável no mercado.
Seja usando IA para gerar ideias, protótipos, conteúdos ou produtos, a forma como você transforma essas criações em algo que faz sentido para o cliente final depende da sua capacidade de pensar na interação humano-sistema.
O risco de criar algo incompreensível (ou inútil)
Ao desenvolver um produto com Inteligência Artificial, é comum o entusiasmo com as possibilidades técnicas acabar ofuscando aspectos essenciais da experiência do usuário. Porém, por mais avançada que seja a solução, se ninguém entende ou consegue utilizá-la, ela falha em gerar valor.
Exemplo: Criando um Negócio com Apoio da IA
Suponha que você queira lançar um microserviço para donos de restaurantes que desejam gerar posts automáticos para o Instagram a partir do cardápio.
Ou seja, até aqui, quase tudo foi desenvolvido com ferramentas de IA generativa.
Mas há uma pergunta crítica a ser feita: o usuário final realmente entende, precisa e sabe usar essa solução?
Mesmo com todas essas facilidades, o sucesso do negócio ainda depende de um fator humano essencial: a clareza da proposta de valor para quem vai usar. É aí que muitos projetos falham. A experiência do usuário continua sendo o que realmente define o sucesso de um produto.
Em resumo: a IA pode construir o produto, mas é a UX que convence as pessoas a usá-lo e pagar por ele.
Antes de lançar seu produto com IA, é fundamental garantir que a experiência do usuário esteja à altura. O checklist a seguir reúne os principais pontos de atenção em UX para transformar uma boa ideia automatizada em uma solução realmente utilizável e desejada.
| Pergunta | Por que importa? |
|---|---|
| O que o negócio faz está claro em uma frase? | Clareza vende. |
| O usuário vê valor sem precisar de explicação? | Time-to-value curto = retenção. |
| O fluxo de uso é simples, sem fricção? | Complexidade mata MVPs. |
| A entrega da IA foi “lapidada”? | A IA gera bruto, você entrega valor. |
| Existe um CTA claro (teste, compre, agende)? | Toda boa UX direciona ação. |
UX é o filtro entre criação e mercado
- Liu, P., Yuan, W., Fu, J., Jiang, Z., Hayashi, H., & Neubig, G. (2023). Summary of Prompt Engineering. arXiv Preprint arXiv:2302.11382.
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., & others. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. Advances in Neural Information Processing Systems, 33, 9459–9474.
- Fielding, R. T. (2000). Architectural styles and the design of network-based software architectures [Phdthesis]. University of California, Irvine.
- Wu, T., Wang, D., Zhang, J., Kim, J., & Horvitz, E. (2022). AI-assisted coding: Copilot or autopilot? Proceedings of the 2022 CHI Conference on Human Factors in Computing Systems, 1–15.
- Armbrust, M., Fox, A., Griffith, R., Joseph, A. D., Katz, R. H., Konwinski, A., Lee, G., Patterson, D., Rabkin, A., Stoica, I., & Zaharia, M. (2010). A view of cloud computing. Communications of the ACM, 53(4), 50–58.